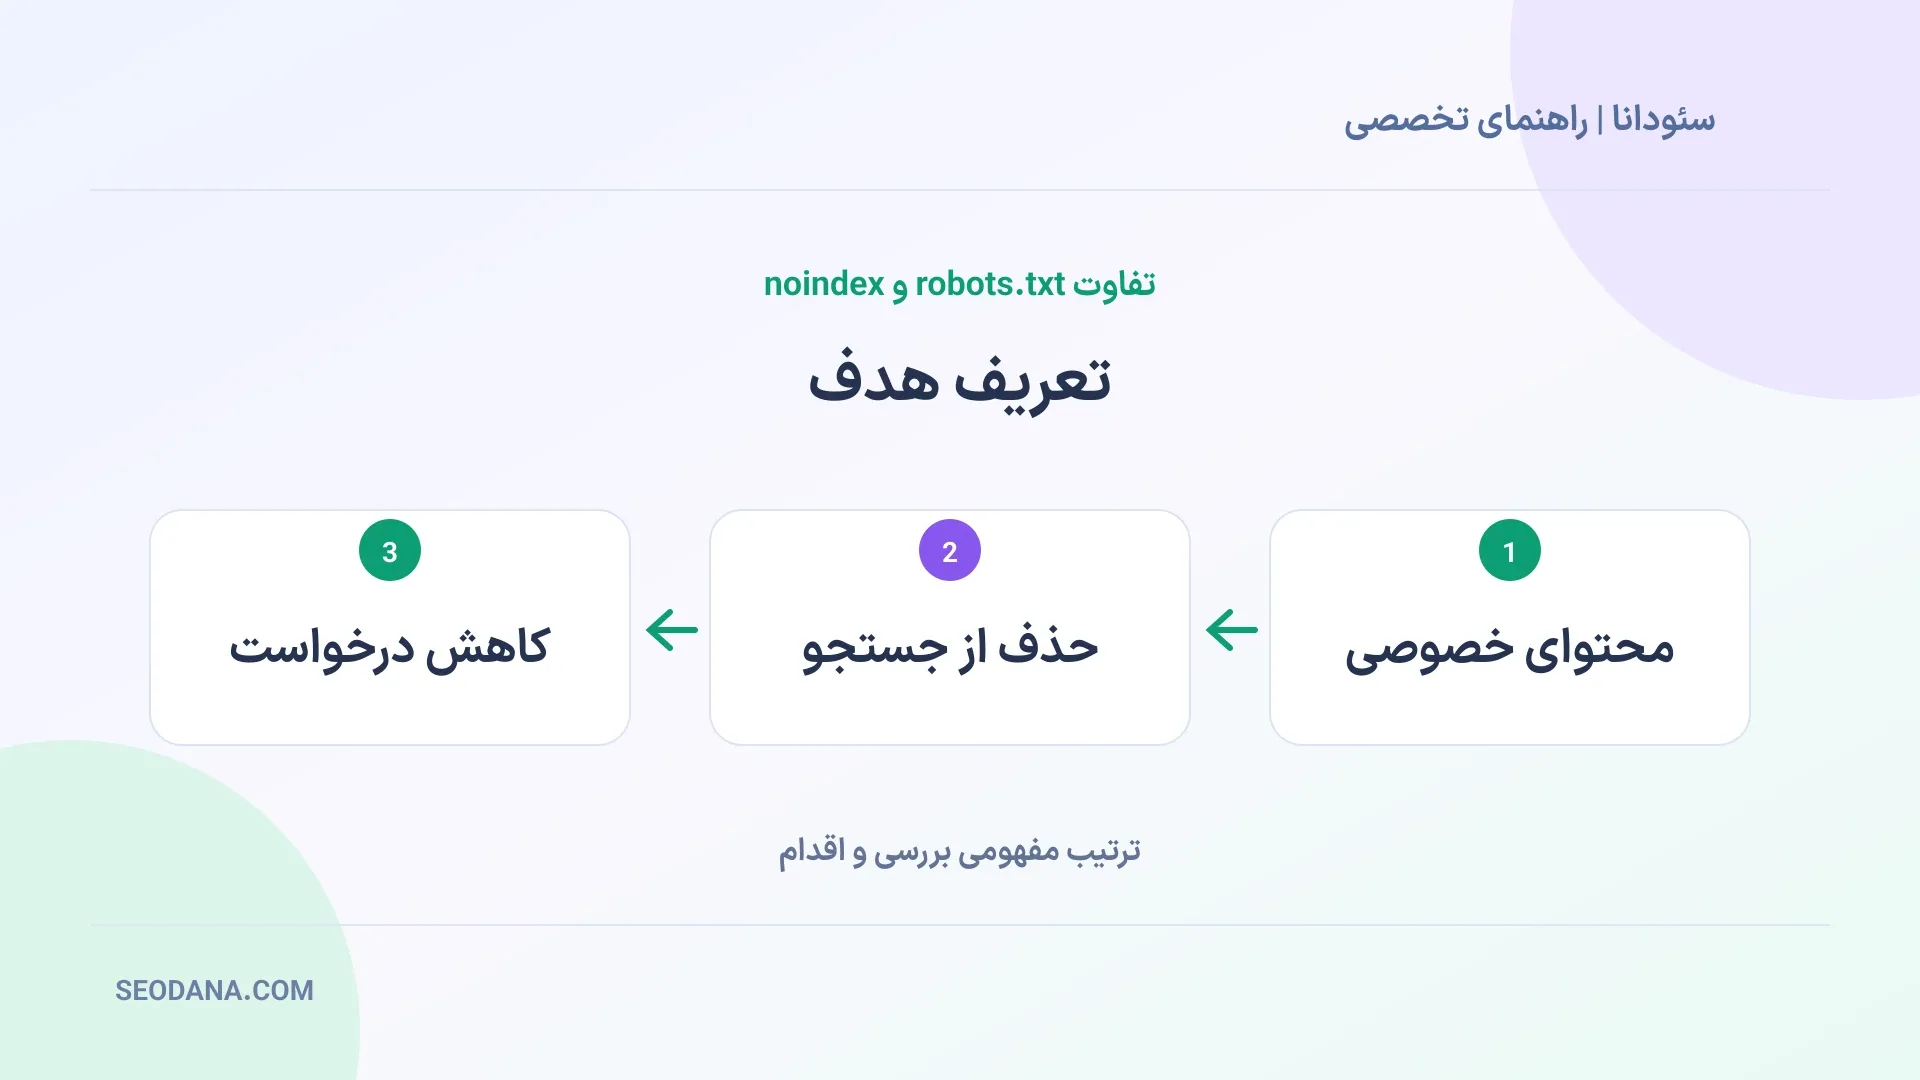
robots.txt و noindex دو مسئله متفاوت را مدیریت میکنند. اولی درباره اجازه درخواست خزنده است و دومی درباره حضور محتوا در نتیجه جستجو. اشتباه گرفتن آنها میتواند باعث باقی ماندن URL در جستجو یا دیده نشدن دستور حذف شود. تصمیم درست از تعریف هدف شروع میشود. آیا محتوا خصوصی است، آیا فقط نباید در جستجو دیده شود یا میخواهیم درخواستهای بیفایده کم شوند؟ پاسخ هر کدام، ابزار و آزمون متفاوتی میخواهد.
پیش از شروع بدانید
robots.txt برای مدیریت درخواست خزنده است و ابزار حفاظت اطلاعات نیست.
برای دیده شدن noindex، خزنده باید بتواند پاسخ صفحه را دریافت کند.
صفحه خصوصی باید کنترل دسترسی واقعی داشته باشد.
چگونه ابزار متناسب با هدف را انتخاب کنیم؟
فایل robots.txt در ریشه هر میزبان قرار میگیرد و قواعد درخواست خزنده را اعلام میکند. دامنه اصلی و زیردامنه، فایل و محدوده جدا دارند. وجود قاعده در یک میزبان به معنی اعمال خودکار آن روی میزبان دیگر نیست. در ممیزی باید نسخه واقعی فایل برای هر میزبان مهم دیده شود، بهویژه وقتی CDN یا چند سرویس مستقل در پاسخ دخالت دارند.
مسدود کردن درخواست، همیشه به معنی خارج شدن URL از جستجو نیست. موتور جستجو ممکن است آدرس را از لینکهای دیگر بشناسد، حتی اگر محتوای آن را دریافت نکند. بنابراین برای هدف حذف از نتیجه، اتکا به Disallow بهتنهایی انتخاب مطمئنی نیست. باید میان شناخته شدن یک آدرس و پردازش محتوای آن تفاوت گذاشت تا ابزار مناسب انتخاب شود.
دستور noindex در متای robots یا هدر X-Robots-Tag اعلام میشود. برای اعمال آن، خزنده باید پاسخ حاوی دستور را ببیند. اگر همان URL در robots.txt مسدود باشد، ممکن است به دستور دسترسی پیدا نکند. این ترکیب یکی از علتهای رایج سردرگمی است، چون مدیر همزمان قصد جلوگیری از درخواست و خارج کردن صفحه از نتیجه را دارد.
برای فایلهایی مانند PDF، هدر پاسخ گزینه قابل بررسی است. افزودن متای HTML به فایل دانلودی معنی ندارد. قاعده هدر باید در سرور یا لایه ارائه فایل تنظیم و روی پاسخ واقعی آزمایش شود. اگر چند فایل با نقش متفاوت از یک مسیر سرو میشوند، قاعده فراگیر میتواند فایل عمومی و ارزشمند را هم تحت تاثیر قرار دهد و نیازمند نمونهگیری دقیق است.
محتوای خصوصی به احراز هویت و محدودیت دسترسی نیاز دارد. robots.txt فهرستی عمومی و قابل خواندن است و نباید محل پنهان کردن نشانی فایل حساس باشد. رمزگذاری، سطح دسترسی و تنظیم سرویس ذخیرهسازی موضوع جداگانهاند. اگر اطلاعاتی نباید دیده شود، باید دریافت آن برای فرد غیرمجاز متوقف شود، نه اینکه تنها از خزنده درخواست کنیم سراغ آن نرود.
در محیط آزمایش، محافظت با ورود یا محدودیت شبکه معمولا پایه روشنتری دارد. اگر صرفا به noindex تکیه شود، حذف تصادفی دستور میتواند محیط را در معرض خزش قرار دهد. هنگام انتقال به تولید نیز باید بررسی شود قواعد محیط تست همراه نسخه منتشر نشده باشند. این رفت و برگشت، به یک چک روشن در فرآیند استقرار نیاز دارد.
آرشیوهای وردپرس را یکسان قضاوت نکنید. صفحه نویسنده متخصص یا دستهای با نقش روشن ممکن است ارزش مستقل داشته باشد. در مقابل، تگهای پراکنده و کممحتوا شاید به بازطراحی یا مدیریت ایندکس نیاز داشته باشند. تصمیم باید از نقش صفحه و کیفیت پاسخ بیاید. روشن کردن یک گزینه عمومی افزونه، جای سیاست مشخص برای هر نوع آرشیو را نمیگیرد.
مدیریت فیلتر و پارامتر هم از تعیین ارزش گروه URL شروع میشود. اگر هدف کاهش فضای درخواست بیفایده باشد، robots.txt میتواند بخشی از راهحل باشد. اگر بعضی صفحهها اکنون ایندکس هستند و باید حذف شوند، دسترسی به دستور مناسب اهمیت دارد. ترتیب اقدامها باید با وضعیت فعلی صفحهها هماهنگ باشد تا یک ابزار، کار ابزار دیگر را مسدود نکند.
برای هر قاعده، دلیل و محدوده نوشته شود. عبارتی مانند مسدود کردن همه مسیرهای دارای علامت سوال، ممکن است صفحههای مفید را نیز بگیرد. نمونههای مجاز و غیرمجاز کنار قاعده ثبت شوند. این یادداشت کوچک، در زمان تغییر فروشگاه یا افزودن قابلیت تازه کمک میکند تیم بفهمد کدام تصمیم قدیمی هنوز معتبر است و چه چیزی باید بازبینی شود.
برای بررسی جزئیات در مستندات اصلی، راهنمای جلوگیری از ایندکس را ببینید.
برای بررسی جزئیات در مستندات اصلی، مقدمه فایل robots.txt را ببینید.
چگونه قواعد را بدون آسیب به صفحه های مهم اجرا کنیم؟
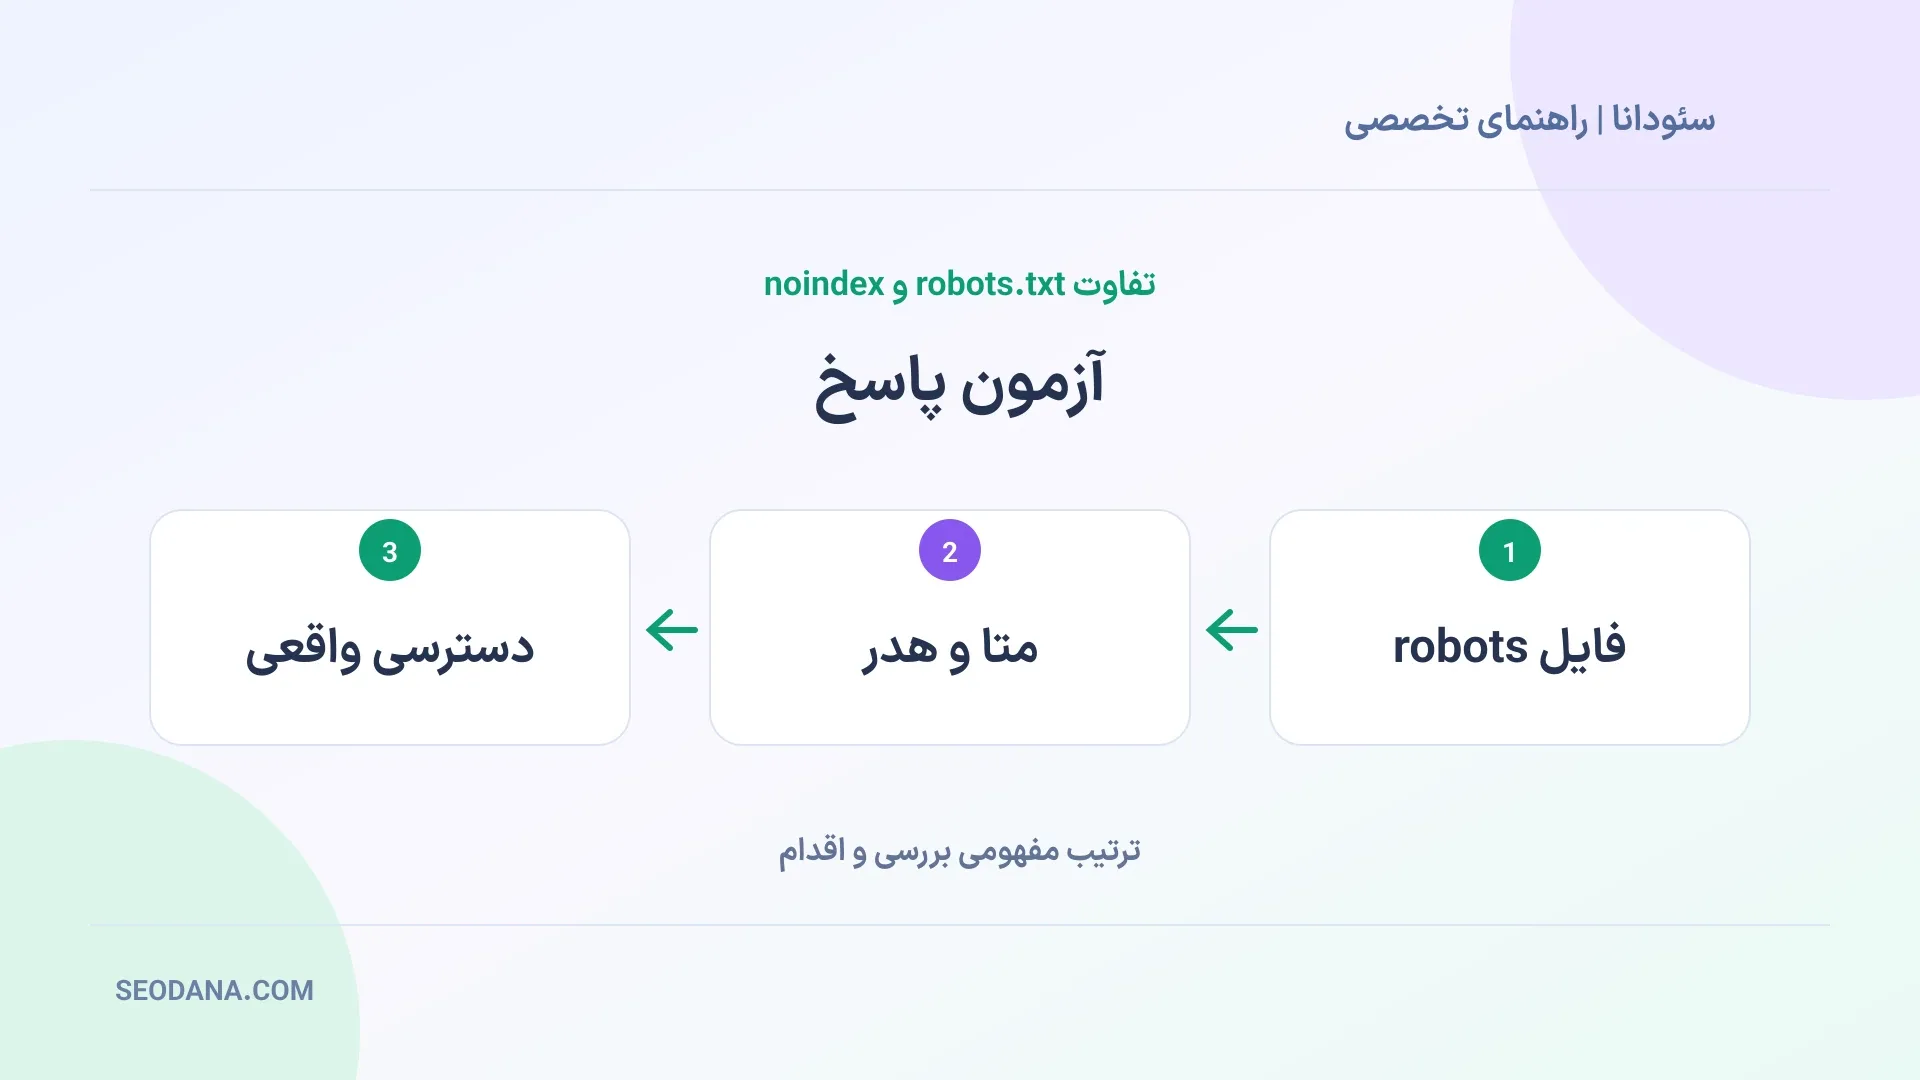
پیش از تغییر، نسخه فعلی فایل و هدرها ذخیره شود. سپس چند URL کنترلی از صفحه اصلی، مقاله، محصول، آرشیو و مسیر پارامتری انتخاب شوند. برای هر نمونه، رفتار مطلوب خزش و ایندکس نوشته شود. تست نباید فقط روی صفحهای انجام شود که قصد حذف آن را داریم. نمونه سالم هم لازم است تا اثر ناخواسته قاعده فراگیر زود دیده شود.
robots.txt را از مسیر عمومی همان دامنه دریافت کنید. پاسخ CDN، کش و میزبان ممکن است با فایلی که روی سرور ویرایش شده متفاوت باشد. کد پاسخ، محتوای نهایی و قواعد مربوط به خزنده هدف بررسی شوند. دیدن نسخه درست در پنل مدیریت، تایید نمیکند که همان نسخه به درخواست بیرونی تحویل داده میشود و لایههای میان راه نیز باید در نظر گرفته شوند.
برای noindex، سورس HTML و هدر پاسخ با هم بررسی شوند. دستورهای متناقض یا چند منبع تولید ممکن است در قالب و افزونه پخش شده باشند. اگر متا بعد از رندر اضافه میشود، خروجی قابل مشاهده برای خزنده نیز آزمایش شود. هدف، یک تصمیم روشن در پاسخ نهایی است و صرف وجود عبارت index در یک بخش از صفحه کافی نیست.
برای یک صفحه HTML در نمونه آموزشی، <meta name="robots" content="noindex"> باید در head پاسخ قرار بگیرد. برای فایل، هدر X-Robots-Tag: noindex قابل بررسی است. دستور curl -sS -D - https://example.com/page/ میتواند هدر و بدنه پاسخ را برای مشاهده اولیه نشان دهد. دامنه نمونه باید با مقصد مورد بررسی عوض شود. اگر URL در robots.txt مسدود است، ابتدا تعارض دسترسی حل شود. دیدن دستور در مرورگر مدیر، جای دریافت عمومی همان پاسخ را نمیگیرد.
پس از تغییر، کش مرتبط با فایل یا صفحه با روش محدود پاک شود. پاک کردن کامل کش کل سایت برای هر اصلاح کوچک میتواند بار غیرضروری بسازد. یک درخواست تازه بگیرید و تاریخ پاسخ و دستورها را دوباره کنترل کنید. اگر CDN قواعد هدر جدا دارد، آن بخش هم بررسی شود تا نسخه سالم HTML زیر هدر اشتباه پنهان نماند.
در ابزار بررسی URL، وضعیت دسترسی و نسخه آخر پردازششده از هم جدا خوانده شوند. تست زنده درباره خروجی کنونی کمک میکند، اما داده ایندکس میتواند مربوط به گذشته باشد. انتظار تغییر فوری گزارش، معیار مناسبی برای شکست اصلاح نیست. ابتدا ثابت شود دستور فعلی درست و در دسترس است، سپس روند پردازش آن در گزارش دنبال شود.
حذف فوری یک URL از نمایش، موضوعی متفاوت از اصلاح دائمی دسترسی و ایندکس است. ابزارهای حذف موقت ممکن است برای شرایط مشخص کاربرد داشته باشند، اما جای حذف محتوا، احراز هویت یا دستور مناسب را نمیگیرند. اگر اطلاعات حساس افشا شده، مسئله باید از منبع دسترسی حل شود. پنهان شدن موقت نتیجه، امنیت فایل باقیمانده روی سرور را برقرار نمیکند.
در انتشار نسخه تازه، آزمون جلوگیری از noindex ناخواسته روی صفحههای اصلی اجرا شود. این آزمون میتواند چند URL کلیدی و خروجی قالبها را پوشش دهد. شکست آن باید پیش از استقرار عمومی دیده شود. همین روش برای robots.txt نیز کاربرد دارد و مانع انتقال فایل محیط تست با قاعده مسدودسازی گسترده به سایت اصلی میشود.
اثر اصلاح با تعداد صفحههای مطلوب و نامطلوب سنجیده شود، نه صرف افزایش تعداد ایندکس. هدف ممکن است کاهش آرشیوهای بیفایده و حفظ محصولات مهم باشد. گزارش باید نشان دهد کدام گروه به وضعیت مورد نظر نزدیک شده است. اگر همه چیز با یک عدد کلی سنجیده شود، حذف ناخواسته صفحههای مفید میتواند پشت یک نمودار ظاهرا مطلوب پنهان بماند.
سیاست نهایی باید برای تیم توسعه و محتوا قابل اجرا باشد. مشخص شود چه کسی قاعده میسازد، چه کسی تایید میکند و کدام نمونهها پس از تغییر آزمایش میشوند. تفکیک روشن امنیت، خزش و ایندکس، انتخاب ابزار را سادهتر میکند. با این تفکیک، هر دستور برای هدف خودش استفاده میشود و عیبیابی نیز بر پایه رفتار واقعی پاسخ انجام میگیرد.
| هدف | راهکار اصلی | آزمون |
|---|---|---|
| خصوصی ماندن محتوا | کنترل دسترسی | درخواست بدون ورود |
| عدم حضور HTML در جستجو | متای noindex | پاسخ و دسترسی خزنده |
| عدم حضور فایل در جستجو | هدر X-Robots-Tag | هدر فایل نهایی |
| محدود کردن درخواست بی فایده | قواعد robots.txt | نمونه مجاز و غیرمجاز |
برای بررسی جزئیات در مستندات اصلی، مشخصات متای robots و هدر را ببینید.
پرسش های رایج
Disallow همان noindex است؟
خیر. Disallow درباره درخواست خزنده است و noindex درباره حضور محتوا در نتیجه جستجو. صفحه مسدودشده ممکن است از مسیر لینک شناخته شود، بدون اینکه خزنده بتواند دستور noindex آن را ببیند.
برای فایل PDF چطور noindex بگذاریم؟
میتوان X-Robots-Tag را در هدر پاسخ فایل تنظیم کرد. هدر باید روی پاسخ واقعی فایل و برای همان محدوده مورد نظر آزمایش شود تا فایلهای عمومی دیگر اشتباهی تحت تاثیر قرار نگیرند.
پوشه خصوصی را در robots.txt بنویسیم؟
این فایل ابزار امنیت نیست و خودش عمومی است. پوشه خصوصی باید احراز هویت و کنترل مجوز دریافت داشته باشد. استفاده از robots.txt جای جلوگیری واقعی از دسترسی را نمیگیرد.
محمد حسین سرمد
محمد حسین سرمد، متخصص و مشاور سئو و بنیانگذار سئودانا است. فعالیت او در سئو از سال 1392 آغاز شده و تجربه نویسندگی و بررسی فناوری، در کنار شناخت توسعه و مدیریت وبسایت، به رویکرد کاری او شکل داده است. تمرکز این رویکرد بر پیوند دادن نیاز مخاطب، ساختار درست سایت و هدف کسبوکار است.
پروفایل و زمینه های تخصصی