داده ساختاریافته، اطلاعات صفحه را در قالبی قابل پردازش معرفی میکند. هدف آن ساختن ستاره یا امتیاز نمایشی به هر قیمت نیست. باید موجودیتها و ویژگیهایی را توضیح دهد که در صفحه و کسبوکار واقعا وجود دارند. پیادهسازی خوب از شناخت نوع صفحه شروع میشود و با هماهنگی محتوا، شناسهها و آزمون خروجی ادامه پیدا میکند. این راهنما نشان میدهد چگونه JSON-LD را از یک کد تزئینی به بخشی قابل نگهداری از مدل محتوای سایت تبدیل کنیم.
پیش از شروع بدانید
اسکیما باید با محتوای قابل مشاهده و واقعیت صفحه هماهنگ باشد.
Schema.org و قابلیت پشتیبانیشده گوگل یک دامنه یکسان ندارند.
عبور از تست، نمایش نتیجه غنی را تضمین نمیکند.
چگونه نوع داده و موجودیت های واقعی را انتخاب کنیم؟
ابتدا نقش صفحه تعیین شود. مقاله، محصول قابل خرید، معرفی سازمان و صفحه خدمت، اطلاعات یکسانی ندارند. انتخاب نوع باید با محتوای اصلی و هدف صفحه هماهنگ باشد. افزودن نوعهای فراوان برای پوشش هر احتمال، مدل را دقیقتر نمیکند. بهتر است هر موجودیت با ویژگیهای درست و رابطه روشن معرفی شود تا مصرفکننده داده بداند درباره چه چیزی صحبت میکنیم.
واژگان Schema.org گستردهتر از قابلیتهای نتیجه غنی گوگل هستند. وجود یک نوع معتبر در واژگان، به معنی پشتیبانی آن برای نمایش ویژه در جستجو نیست. پیش از طراحی خروجی مورد انتظار، راهنمای همان قابلیت بررسی شود. این تفاوت کمک میکند تیم بین معنیدار بودن مدل داده و شرایط فنی یک نمایش خاص، ادعای نادرست یا وعده قطعی نسازد.
شناسه پایدار برای موجودیتهای تکرارشونده اهمیت دارد. سازمان یا نویسندهای که در چند صفحه معرفی میشود، بهتر است هویت منسجم داشته باشد. تغییر نام یا تصویر نباید بیدلیل به ساخت موجودیت تازه منجر شود. آدرس شناسه و صفحه معرفی باید با سیاست URL سایت هماهنگ بمانند تا رابطه میان مقاله، نویسنده و ناشر قابل فهم و قابل نگهداری باشد.
برای سازمان در یک دامنه نمونه میتوان شناسه پایدار https://example.com/#organization تعریف کرد و در مقالههای همان ناشر به آن ارجاع داد. این شناسه نباید برای هر مقاله با نام تازه بازسازی شود. تصویر، نشانی و نام نیز از منبع سازمان خوانده شوند. استفاده از شناسه ثابت، مجوز افزودن اطلاعات نامعلوم نیست. مدل باید رابطه واقعی ناشر و محتوا را توضیح دهد و صفحه معرفی سازمان نیز اطلاعات سازگار و قابل بررسی ارائه کند.
داده از منبع معتبر CMS خوانده شود. نام نویسنده، تاریخ انتشار، تصویر و عنوان نباید در چند فایل جدا بهصورت دستی تکرار شوند. پراکندگی منبع باعث میشود متن صفحه تازه شود اما JSON-LD قدیمی بماند. یک مدل محتوای روشن، امکان تولید هماهنگ متا و اسکیما را میدهد و اصلاح اطلاعات نیز تنها در محل مسئول انجام میشود.
ویژگیهای اجباری و پیشنهادی را از راهنمای نوع مربوط بخوانید. نبود یک ویژگی ضروری ممکن است شرایط نمایش ویژه را از بین ببرد. ویژگی پیشنهادی هم فقط زمانی اضافه شود که داده درست در اختیار است. ساخت مقدار تخمینی یا نامطمئن برای سبز شدن تست، کیفیت خروجی را بهتر نمیکند و میتواند مدل را با محتوای واقعی ناسازگار کند.
امتیاز و نظر باید از منبع واقعی و با رعایت سیاست مربوط بیایند. یک امتیاز ساختگی برای صفحه خدمت، صرفا چون از نظر نحو معتبر است، مجاز یا مفید نمیشود. مدل داده باید آنچه کاربر واقعا میبیند و تجربه واقعی موجود را توصیف کند. مسئول محتوا باید بداند هر عدد از کجا آمده و چه محدودهای را نمایندگی میکند.
تاریخ انتشار و بهروزرسانی نیز نقش متفاوت دارند. تغییر قالب یا اضافه شدن یک لینک عمومی، لزوما به معنی بازنگری محتوای مقاله نیست. منبع این تاریخها و معیار تغییرشان مشخص شود. اگر صفحه تاریخ نمایشی دارد، با داده ساختاریافته و متادیتا هماهنگ باشد تا مخاطب و مصرفکننده داده با چند زمان متناقض درباره یک محتوا روبهرو نشوند.
در فروشگاه، نام، قیمت، ارز و موجودی باید با پیشنهاد قابل خرید هماهنگ باشند. تغییر موجودی در سیستم فروش، باید در صفحه و داده ساختاریافته نیز منعکس شود. برای محصول دارای گونه، روش معرفی رابطه گونهها از راهنمای مربوط بررسی شود. یک مدل عمومی کپیشده که تفاوت نسخهها را نادیده میگیرد، میتواند اطلاعات انتخاب مشتری را مبهم یا نادرست نشان دهد.
سوالهای متداول نیز نباید به وعده نمایش ویژه تبدیل شوند. وجود چند پرسش در صفحه به معنی واجد شرایط بودن برای هر قالب نتیجه غنی نیست. سیاست و دامنه پشتیبانی قابلیتها تغییر میکند و باید از مستندات رسمی بررسی شود. بهتر است کیفیت پاسخ برای خواننده هدف اصلی بماند و تصمیم افزودن نوع اسکیما از شرایط واقعی همان قابلیت پیروی کند.
برای بررسی جزئیات در مستندات اصلی، مقدمه داده ساختاریافته گوگل را ببینید.
برای بررسی جزئیات در مستندات اصلی، داده ساختاریافته مقاله را ببینید.
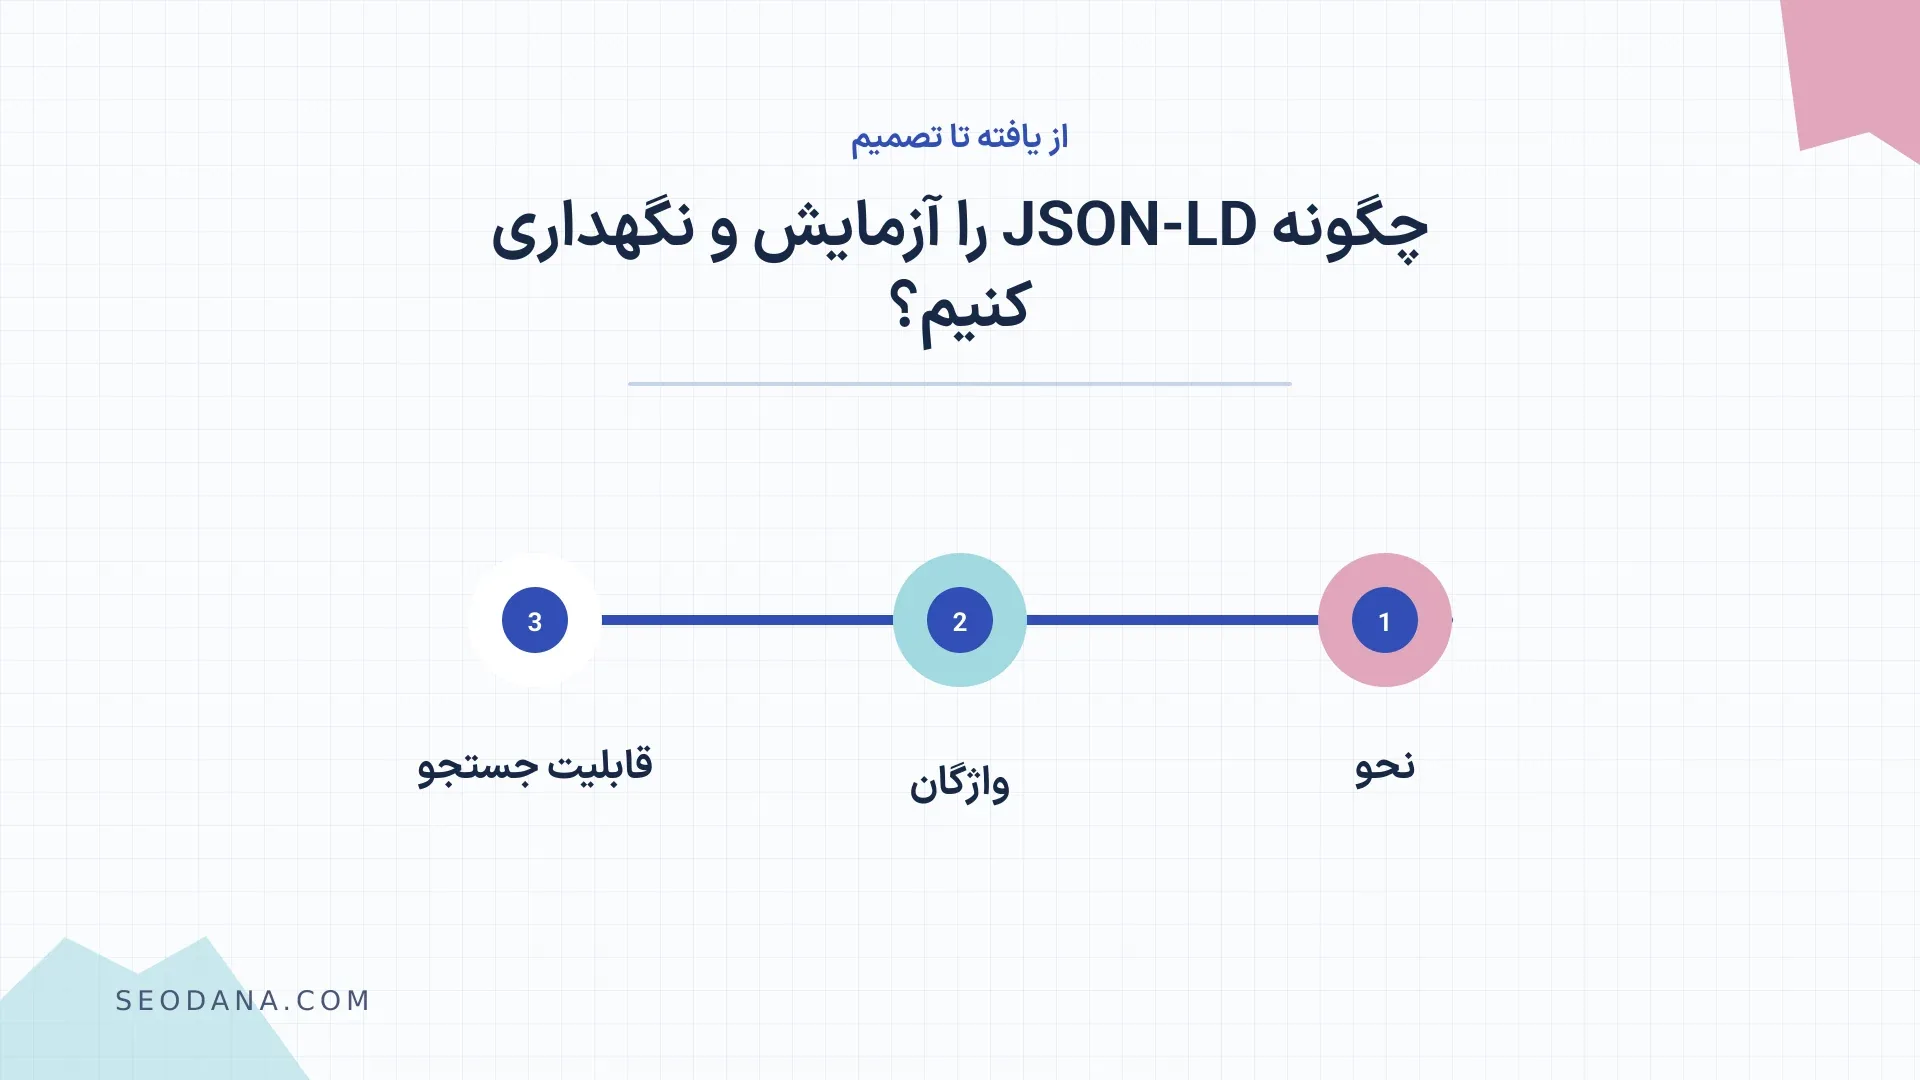
چگونه JSON-LD را آزمایش و نگهداری کنیم؟
در پیادهسازی JSON-LD، ساختار JSON ابتدا از نظر نحو بررسی شود. ویرگول اضافه، نقلقول نامعتبر و نویسه کنترل میتوانند کل بلوک را خراب کنند. تولید کد با serializer معتبر از اتصال دستی رشتهها امنتر و قابل اعتمادتر است. بهویژه وقتی عنوان و توضیح از ورودی CMS میآیند، نویسهها نباید باعث شکستن کد یا تزریق محتوای ناخواسته شوند.
سپس خروجی واقعی صفحه آزمایش شود، نه فقط نمونه کد داخل ابزار. قالب، افزونه و کد سفارشی ممکن است چند بلوک متفاوت تولید کنند. وجود چند بلوک همیشه خطا نیست، اما اطلاعات متناقض درباره موجودیت یکسان باید رفع شود. مسئول تولید هر بخش مشخص شود تا اصلاح یک افزونه با خروجی ثابت قالب دوباره خنثی نشود و داده دو نسخه متفاوت نداشته باشد.
Rich Results Test برای بررسی قابلیتهای پشتیبانیشده گوگل مفید است. ابزار اعتبارسنجی واژگان نیز دامنه متفاوتی دارد. نتیجه این دو باید با هدف آزمون خوانده شود. نبود خطای فنی در یک ابزار، صحت تمام ادعاها و اطلاعات صفحه را تایید نمیکند. بخش محتوایی و انطباق با سیاستها همچنان به بررسی جدا نیاز دارد و با رنگ سبز آزمون جایگزین نمیشود.
برای صفحههای جاوااسکریپتی، مدل دیدهشده پس از رندر کنترل شود. قیمت یا نام نباید از مسیر قبلی برنامه باقی مانده باشد. درخواست مستقیم URL و ناوبری داخلی هر دو آزمایش شوند. اگر داده در زمان دریافت API ساخته میشود، حالت شکست و تاخیر هم بررسی شود تا صفحه خالی یا محصول ناموجود، مدل یک پیشنهاد قابل خرید اشتباه را نگه ندارد.
دسترسی به صفحه و تصویرهای معرفیشده بررسی شود. URL تصویر باید عمومی، معتبر و مرتبط باشد و از میزبان محیط آزمایش نیاید. دادهای که به منبع غیرقابل دریافت اشاره میکند، مدل کاملی برای مصرفکننده نمیسازد. در کنار آن، دستورهای ایندکس صفحه نیز با هدف نمایش هماهنگ شوند تا اسکیما روی صفحهای قرار نگیرد که عمدا از دسترس پردازش خارج شده است.
چند نمونه نماینده از هر قالب در آزمون بمانند. محصول موجود، ناموجود، گونهدار و مقاله دارای نویسنده، حالتهای متفاوتی دارند. یک نمونه سالم برای تایید تمام قالب کافی نیست. داده خالی، نبود تصویر و حذف فیلد اختیاری نیز باید آزمایش شوند تا مولد بهجای رشته تهی یا مقدار ساختگی، رفتار منطقی و قابل پیشبینی داشته باشد.
پس از انتشار، گزارشهای مرتبط سرچ کنسول در بازه مناسب بررسی شوند. خطاهای جدید میتوانند نشانه تغییر قالب یا منبع داده باشند. تعداد موارد معتبر هم باید با فهرست صفحههای مورد انتظار مقایسه شود. کاهش ناگهانی ممکن است از حذف بلوک یا مشکل دسترسی بیاید، نه صرفا از نامعتبر شدن ویژگی. علت باید با نمونه صفحه واقعی پیدا شود.
برای نگهداری، مالک هر داده و زمان بهروز شدن آن مستند شود. قیمت از فروشگاه، مشخصات نویسنده از پروفایل و تاریخ مقاله از فرآیند انتشار میآید. وقتی چند تیم یک موجودیت را تعریف میکنند، اختلاف نام و شناسه بهراحتی ایجاد میشود. یک واژهنامه کوچک و منبع مشترک، مدل را با رشد سایت منسجم نگه میدارد و بازبینی را سادهتر میکند.
خروجی درست اسکیما، توصیف صادقانه و منظم محتوای واقعی است. این کار میتواند شرایط فنی برخی نمایشها را فراهم کند، اما انتخاب نهایی نمایش و رتبه در کنترل کامل سایت نیست. معیار حرفهای، داده قابل پیگیری، هماهنگی با صفحه و توان نگهداری پس از تغییر محتواست. با این معیارها، اسکیما همراه کیفیت اطلاعات رشد میکند و به مجموعهای از کدهای بیصاحب تبدیل نمیشود.
| لایه | پرسش اصلی | ابزار یا روش |
|---|---|---|
| نحو | آیا JSON قابل پردازش است؟ | تجزیه گر معتبر |
| واژگان | آیا نوع و ویژگی معتبرند؟ | اعتبارسنجی Schema.org |
| قابلیت جستجو | آیا شرایط نوع رعایت شده؟ | Rich Results Test |
| درستی محتوا | آیا داده واقعی و قابل مشاهده است؟ | مقایسه با صفحه و منبع CMS |
برای بررسی جزئیات در مستندات اصلی، سیاست های عمومی داده ساختاریافته را ببینید.
پرسش های رایج
اسکیما رتبه را مستقیم تضمین می کند؟
خیر. اسکیما به معرفی ساختار اطلاعات کمک میکند و ممکن است شرایط برخی نمایشهای پشتیبانیشده را فراهم کند. عبور از آزمون فنی، تضمین رتبه یا نمایش نتیجه غنی نیست.
چند افزونه اسکیما همزمان بهتر است؟
تعداد افزونه معیار کیفیت نیست. چند منبع میتوانند داده تکراری یا متناقض بسازند. مسئول هر بلوک، هویت موجودیتها و هماهنگی اطلاعات باید مشخص و روی خروجی نهایی کنترل شوند.
برای ستاره گرفتن امتیاز ثابت اضافه کنیم؟
خیر. امتیاز باید واقعی و با سیاست نوع مربوط سازگار باشد. عدد ساختگی برای گرفتن نمایش ویژه، توصیف درست محتوا نیست و معتبر بودن نحو JSON آن را به داده قابل اعتماد تبدیل نمیکند.
محمد حسین سرمد
محمد حسین سرمد، متخصص و مشاور سئو و بنیانگذار سئودانا است. فعالیت او در سئو از سال 1392 آغاز شده و تجربه نویسندگی و بررسی فناوری، در کنار شناخت توسعه و مدیریت وبسایت، به رویکرد کاری او شکل داده است. تمرکز این رویکرد بر پیوند دادن نیاز مخاطب، ساختار درست سایت و هدف کسبوکار است.
پروفایل و زمینه های تخصصی